文字コード編・第2回
文字コードの種類
ひとことで言うと
文字コードには、日本で作られたShift_JISなどと、世界共通のUTF-8などがあります。今の基本は、UTF-8です。古いシステムや、エクセルの周りには、Shift_JISが残っています。
異動してきたら、最初に確かめること
チェックは、このスマートフォンのブラウザに保存されます。
解説(テキスト版)
はじめに
情シスには、こんな相談が届きます。システムの連携の仕様で、文字コードは何にしますか、と事業者に聞かれる。
あるいは、オープンデータのCSVは、UTF-8とShift_JISの、どちらで出せばいいですか、と聞かれる。
どちらも、文字コードの種類の話です。第2回は、文字コードの種類をお話しします。
一言で言うと
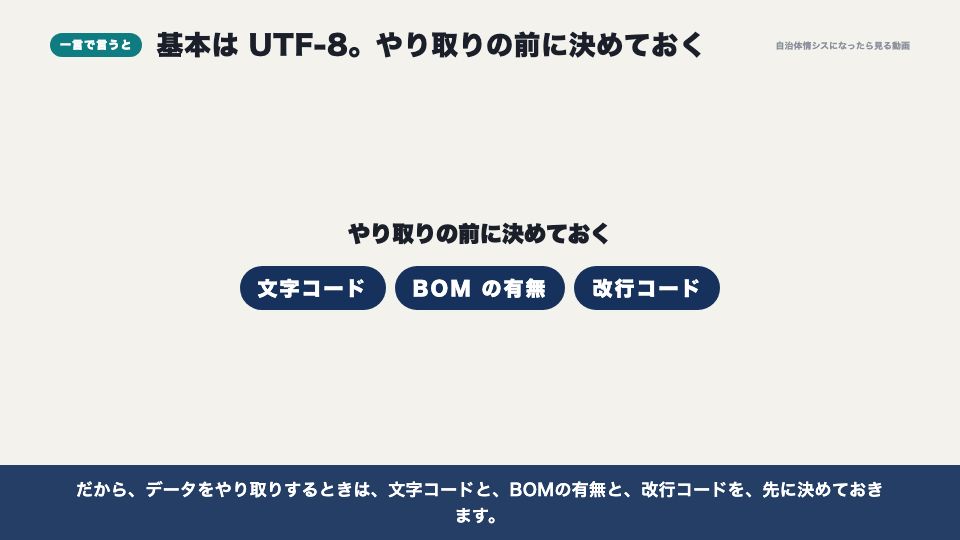
先に、一言でまとめます。文字コードには、日本で作られたShift_JISなどと、世界共通のUTF-8などがあります。今の基本は、UTF-8です。古いシステムや、エクセルの周りには、Shift_JISが残っています。
だから、データをやり取りするときは、文字コードと、BOMの有無と、改行コードを、先に決めておきます。
2つの系統
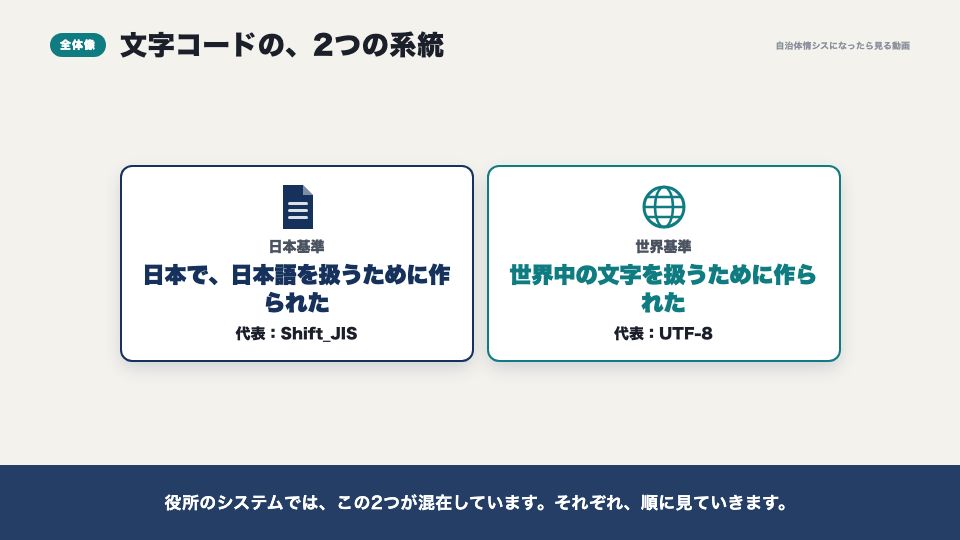
文字コードには、大きく分けて、2つの系統があります。
一つは、日本で、日本語を扱うために作られた、日本基準の文字コードです。代表が、Shift_JISです。
もう一つは、世界中の文字を扱うために作られた、世界基準の文字コードです。代表が、UTF-8です。
役所のシステムでは、この2つが混在しています。それぞれ、順に見ていきます。
日本基準の文字コード
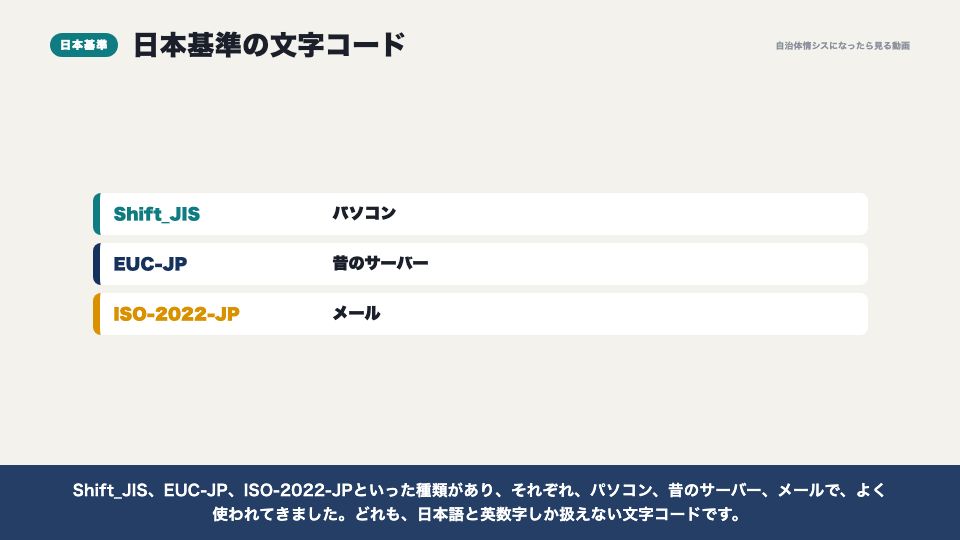
まずは、日本基準の文字コードです。
土台になったのは、ASCIIです。アメリカで作られた、英字と数字と、記号だけの文字コードです。日本語は入っていません。
そこで日本では、ASCIIの英数字に、ひらがな、カタカナ、漢字を加えた文字コードが作られました。漢字は、JISの規格で決められた、およそ6千字です。
Shift_JIS、EUC-JP、ISO-2022-JPといった種類があり、それぞれ、パソコン、昔のサーバー、メールで、よく使われてきました。どれも、日本語と英数字しか扱えない文字コードです。
Shift_JISと、機種依存文字
役所でいちばん長く使われてきたのが、Shift_JISです。ただし、ウィンドウズのShift_JISは、正確には、CP932という、少し広げた版です。
CP932には、丸で囲んだ数字や、ローマ数字、はしごだかの「髙」や、たつさきの「﨑」などが、追加されています。
こうした文字は、ほかのシステムの文字コードにはないことがあり、機種依存文字と呼ばれてきました。送った先で、四角や、別の文字になることがあります。半角のカタカナも、同じように、連携でつまずきやすい文字です。
世界基準の文字コード
ところが、国ごとに文字コードがばらばらだと、海外とのやり取りや、いくつもの言語を扱うときに困ります。
そこで作られたのが、世界中の文字を、一つにまとめたUnicodeです。日本語も、中国語も、アラビア語も、絵文字も入っています。
Unicodeを、ファイルに保存するときの形には、いくつかの種類があります。いちばん使われているのが、UTF-8です。ウェブのページや、オープンデータの標準になっています。
もう一つが、UTF-16です。ウィンドウズの内部や、一部のシステムで使われています。
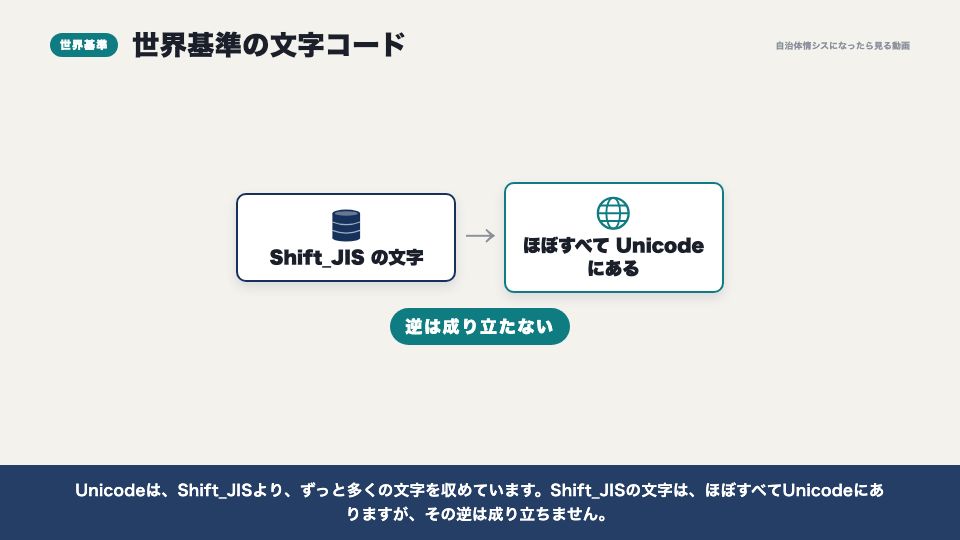
Unicodeは、Shift_JISより、ずっと多くの文字を収めています。Shift_JISの文字は、ほぼすべてUnicodeにありますが、その逆は成り立ちません。
BOM
UTF-8のファイルで、よく出てくるのが、BOMです。
BOMは、ファイルのいちばん先頭に付ける、これはUTF-8です、という目印です。中身は、EF、BB、BFの、3つの番号です。
前回お話ししたとおり、日本語のエクセルは、BOMの付いていないCSVを、Shift_JISとして読むことがあります。BOMを付けておけば、UTF-8として開いてくれます。
ただし、BOMが付いていると、先頭の項目の名前がずれて、読み込めなくなるシステムもあります。付けるか付けないかは、受け取る側に合わせて決めます。
改行コード
文字ではありませんが、もう一つ、連携でよくつまずくのが、改行コードです。
行の終わりを表す印にも、種類があります。ウィンドウズでは、CRとLFの2つを並べるのが一般的です。それ以外の多くの環境では、LFだけです。
受け取る側が、違う改行コードを想定していると、全部が1行につながったり、行の終わりに余分な文字が残ったりします。
自治体の現場では
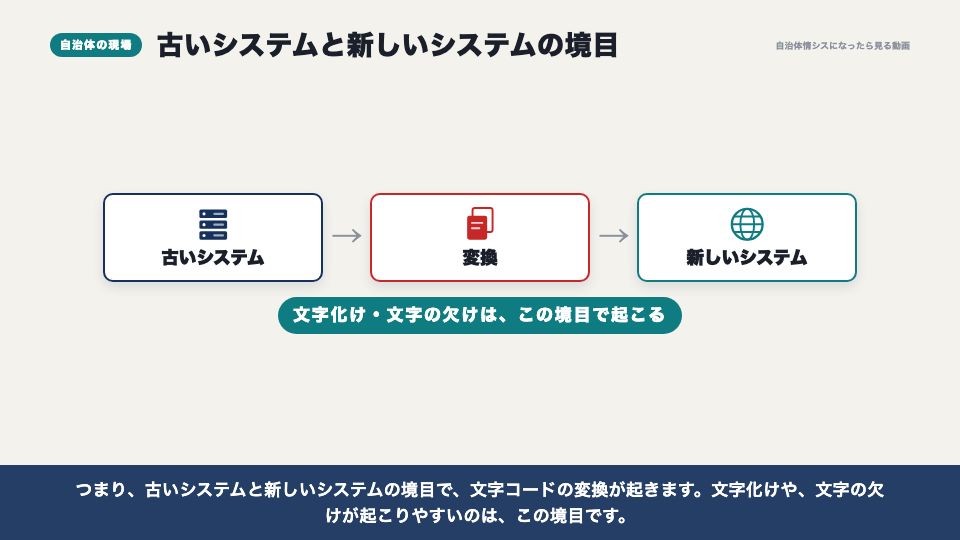
では、自治体の現場では、どうなっているでしょうか。
長く使われてきた基幹システムには、メーカー独自の文字コードを使っているものもあります。ほかのシステムとつなぐときは、その間で、文字コードの変換が入ります。
一方で、クラウドのサービスや、ウェブのシステムは、ほとんどがUTF-8です。オープンデータも、UTF-8で出すのが基本です。
つまり、古いシステムと新しいシステムの境目で、文字コードの変換が起きます。文字化けや、文字の欠けが起こりやすいのは、この境目です。
連携のときに決めること
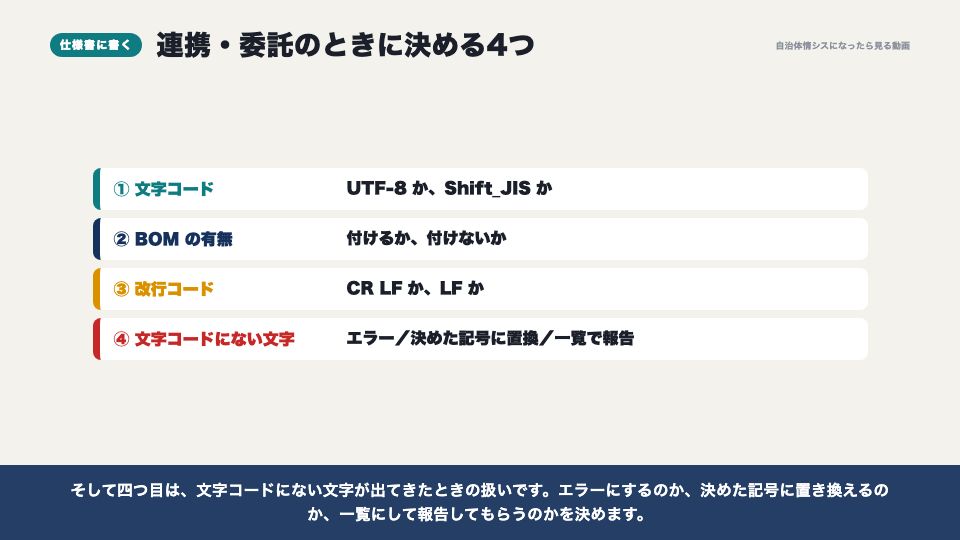
だから、システムを連携するときや、データの作成を委託するときは、仕様書に、次の4つを書いておきます。
一つ目は、文字コードです。UTF-8か、Shift_JISか。二つ目は、BOMの有無です。三つ目は、改行コードです。
そして四つ目は、文字コードにない文字が出てきたときの扱いです。エラーにするのか、決めた記号に置き換えるのか、一覧にして報告してもらうのかを決めます。
現場でよくある誤解
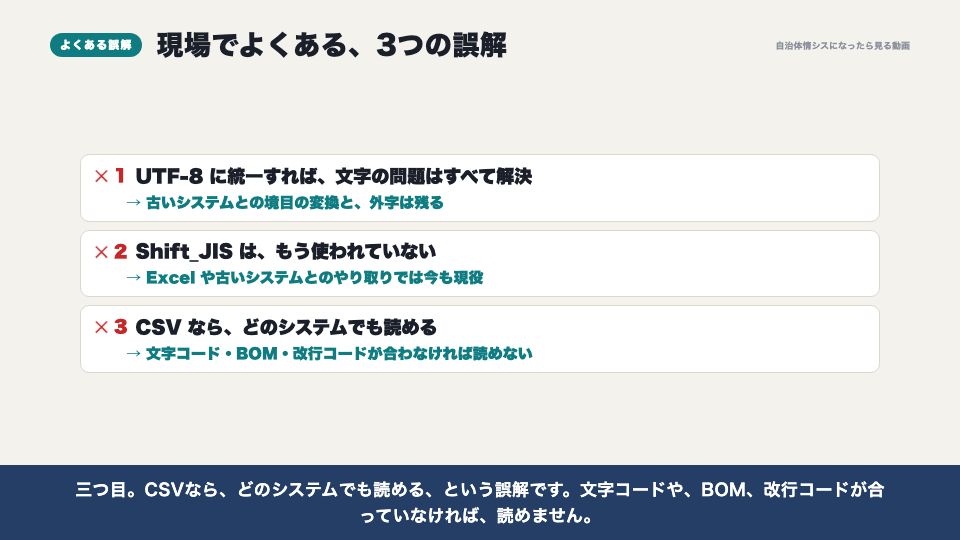
現場でよくある誤解を、3つ挙げます。
一つ目。UTF-8に統一すれば、文字の問題はすべて解決する、という誤解です。古いシステムとの境目では、変換が残ります。次回お話しする外字も、別の問題として残ります。
二つ目。Shift_JISは、もう使われていない、という誤解です。エクセルや、古いシステムとのやり取りでは、今も現役です。
三つ目。CSVなら、どのシステムでも読める、という誤解です。文字コードや、BOM、改行コードが合っていなければ、読めません。
異動してきたら最初に確かめること
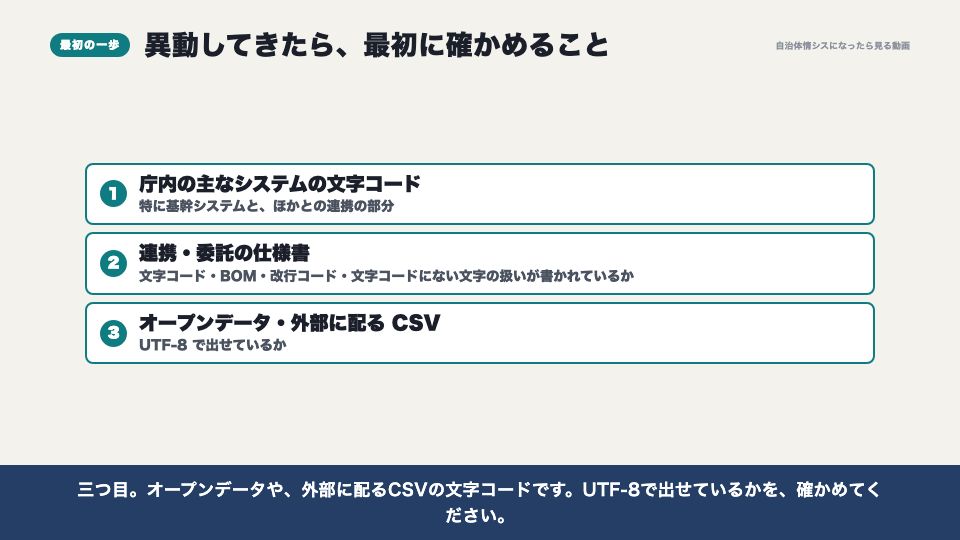
では、異動してきたら、まず何を確かめればいいでしょうか。
一つ目。庁内の主なシステムが、それぞれ、どの文字コードを使っているかです。特に、基幹システムと、ほかのシステムとの連携の部分です。
二つ目。連携や委託の仕様書に、文字コード、BOM、改行コード、文字コードにない文字の扱いが書かれているかです。
三つ目。オープンデータや、外部に配るCSVの文字コードです。UTF-8で出せているかを、確かめてください。
理解度テスト
3問です。答えを選んで、「答え合わせ」を押してください。
結果は、このブラウザに保存されます。成績ページで「ふっかつのじゅもん」を作ると、別の端末でも続きから使えます。